Always-on agent 是怎么运作的
Lee Robinson · Stanford CS146S 客座讲座(How always-on agents work)· 2026 年 10 月 8 日 · 约 45 分钟
原帖:https://x.com/leerob/status/2108650243365736855
一句话概括:在终端里跑的 agent,合上电脑就停了;而“一直在线”的 agent 跑在服务器上,有自己的电脑、记忆和工作流,没事时安静,需要时出现——更像一位同事,而不是一个工具。
开场:你的 agent 和“一直在线”的 agent0:00
标题页(How always-on agents work)0:00
Lee Robinson 在斯坦福 CS146S 的这一讲,主题是“一直在线的 agent 是怎么运作的”。
标题页 免责声明(Safe Harbor Statement)0:12
他先说明:接下来讲的部分内容还在开发中,是在 SpaceX 做的。
Safe Harbor 第一周你就写过它(You built this in week one)0:21
课程第一周大家都写过一个最简单的 agent:
while True: reply = llm(...),在终端里循环调用模型。问题是:合上笔记本,它就停了。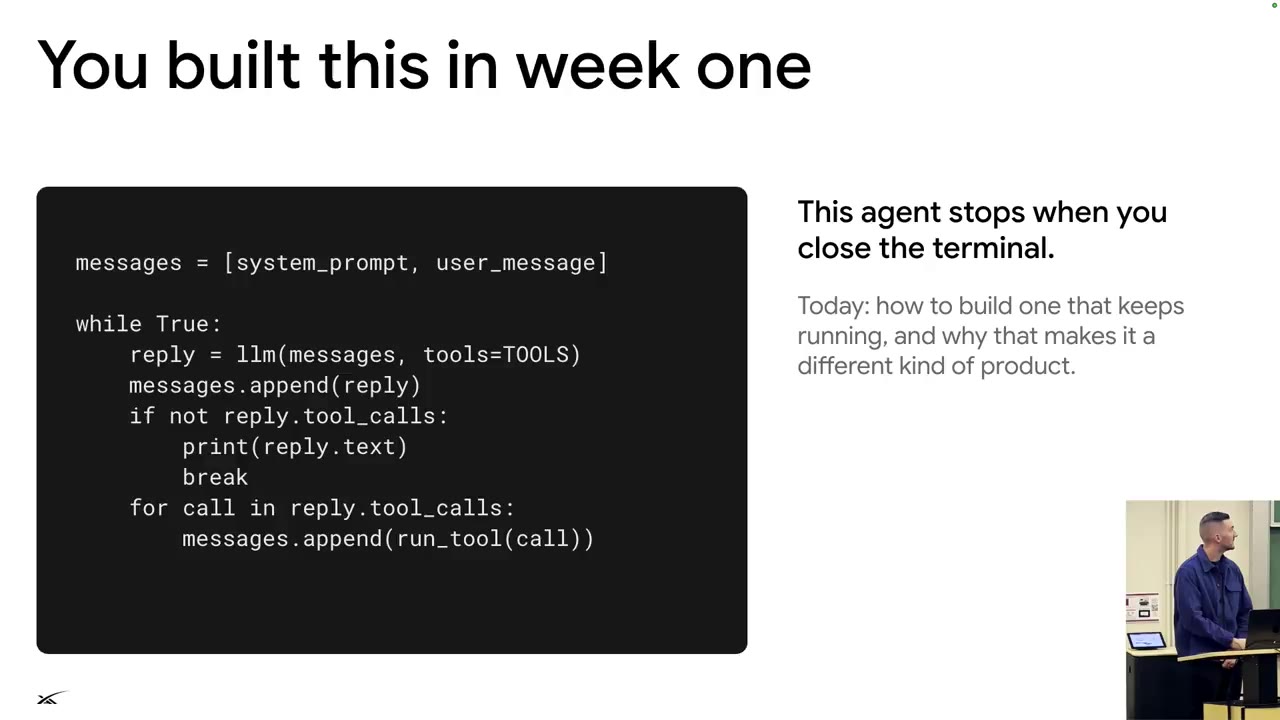
最简 agent 循环 你的 agent vs. 一直在线的 agent(Your agent vs. an always-on agent)0:49
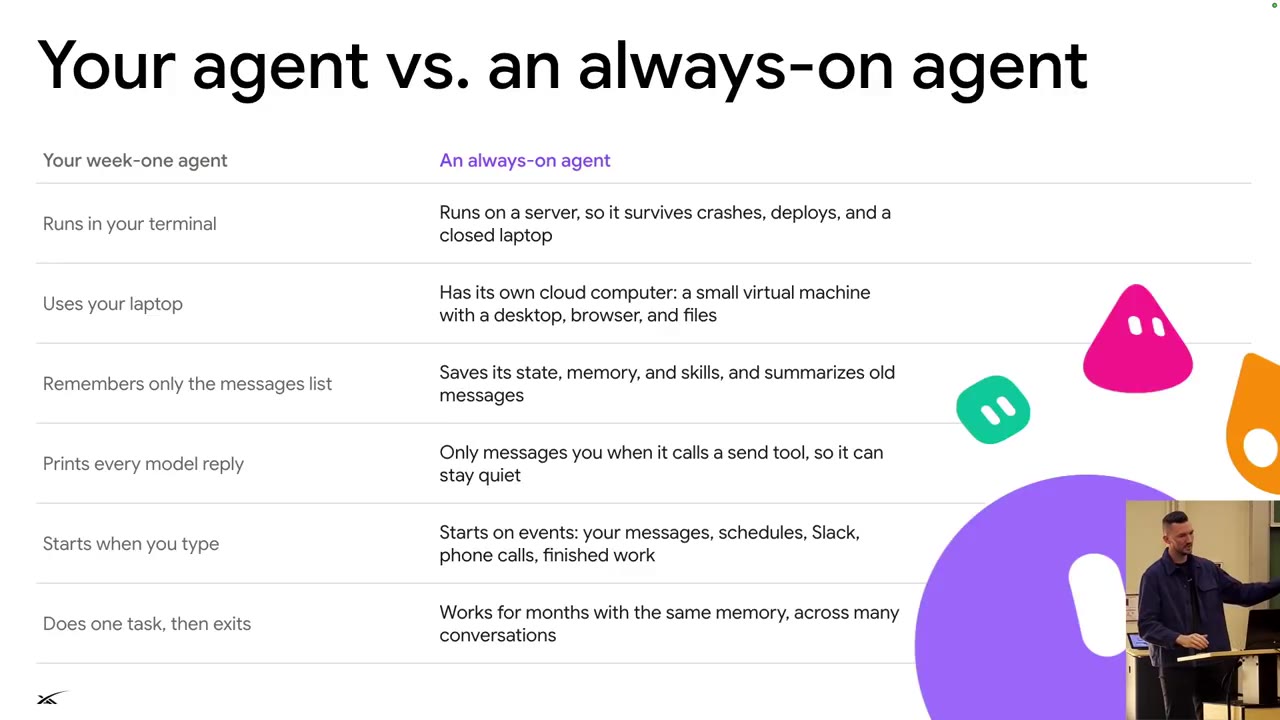
区别列成一张表:跑在服务器上;崩溃了能恢复;有自己的虚拟机和桌面;会保存状态和记忆;没事时保持安静,需要时才出声。
“这种一直在线的 agent 更像一位同事,它不会动不动就给你发消息,它知道什么时候该安静。”(1:30)
对比表 议程(Agenda)2:06
全场分为:怎么走到今天、模型变了什么、always-on agent 内部、harness、上下文工程、未来方向。(议程上列了 Q&A,但这次没有问答环节。)
议程
一、我们是怎么走到这一步的(How we got here)2:35
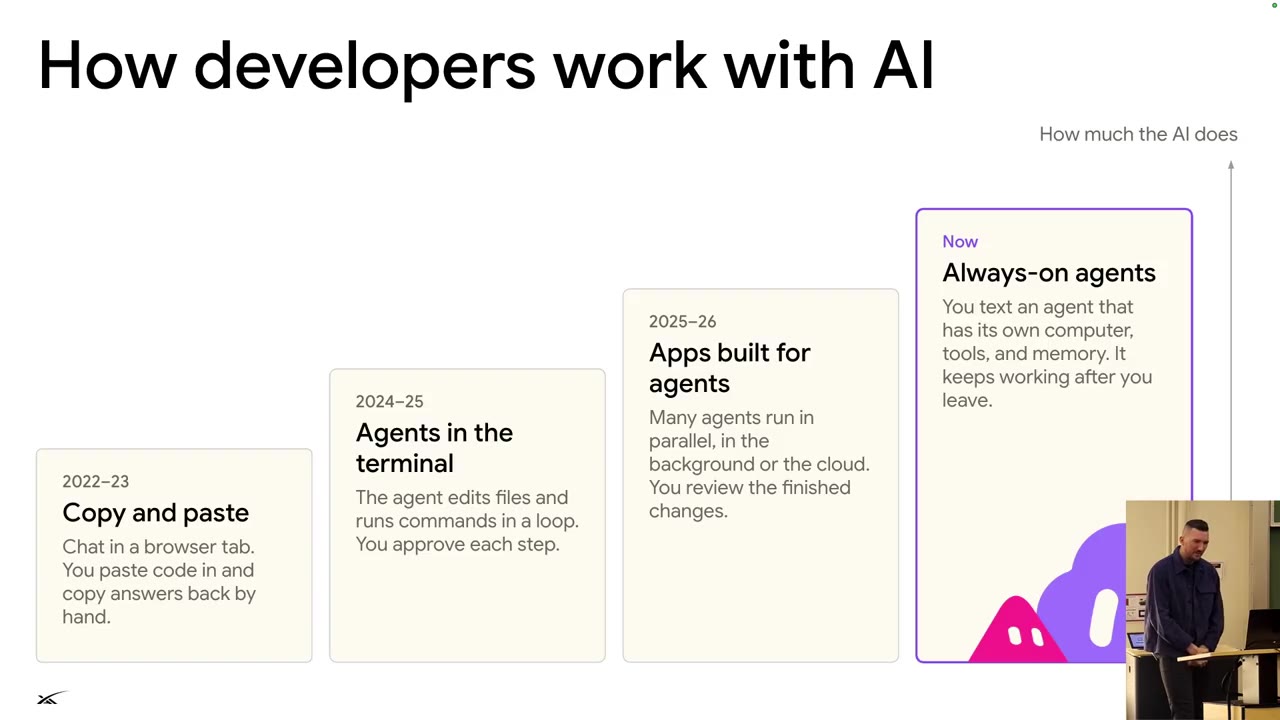
四个阶段2:37
- 复制粘贴(2022–23):在聊天框和编辑器之间来回贴代码。
- 终端里的 agent(2024–25)。
- 为 agent 打造的应用(2025–26)。
- 现在:一直在线的 agent。
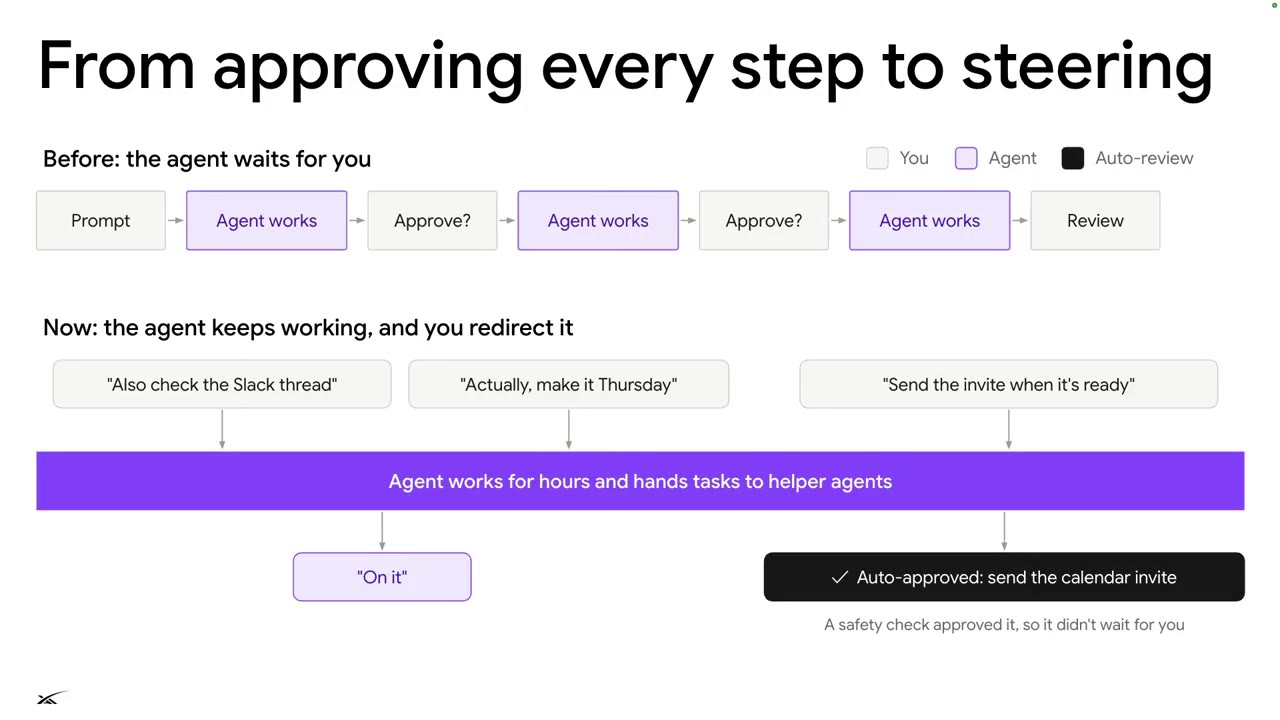
时间线 从逐步审批到随时“掌舵”(From approving every step to steering)4:08
以前人要批准 agent 的每一条命令;现在 agent 一直往下做,人只在需要时发一句话调整方向,比如“其实改成周四吧”。命令的安全性交给一个 Auto-review 模型来检查。
“大多数时候,模型其实做得更好。”(5:27)
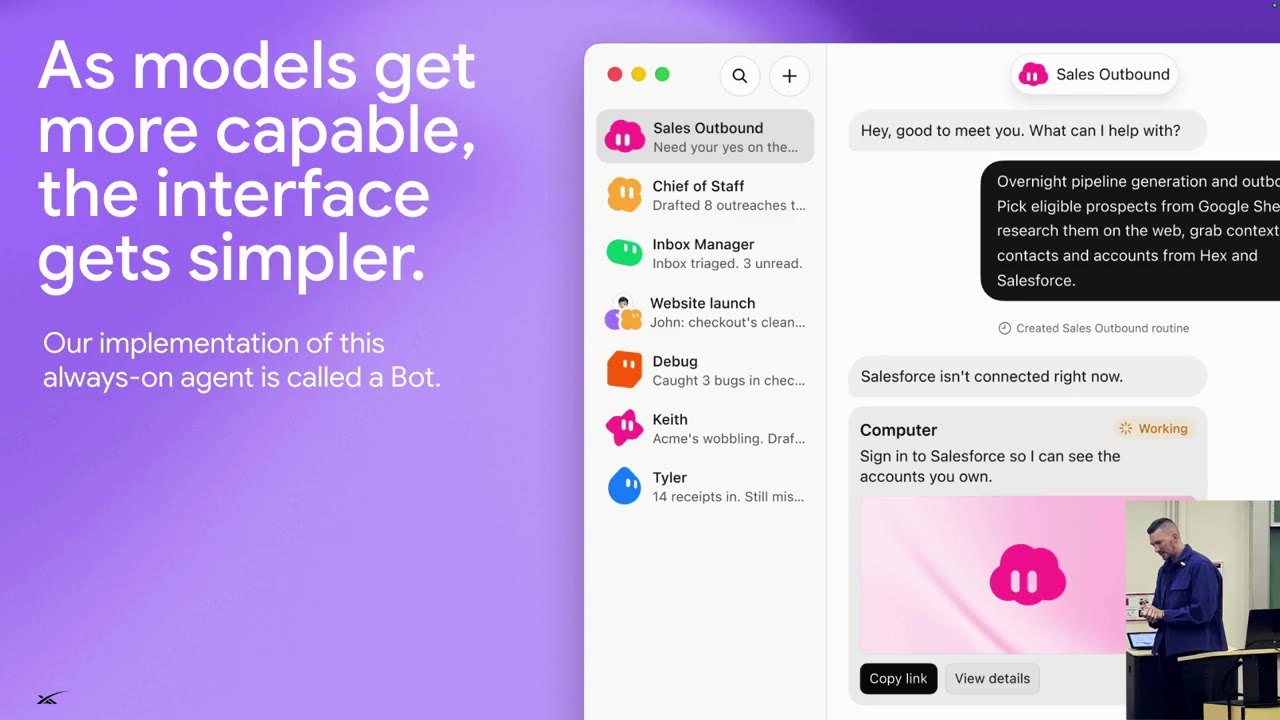
从审批到掌舵 模型越强,界面越简单(As models get more capable, the interface gets simpler)5:30
他演示了一个“Sales Outbound”的聊天界面。用起来的感觉,就像在给一个能真正干活的朋友发短信。
Sales Outbound 演示
二、模型到底变了什么(What changed in the models)6:13
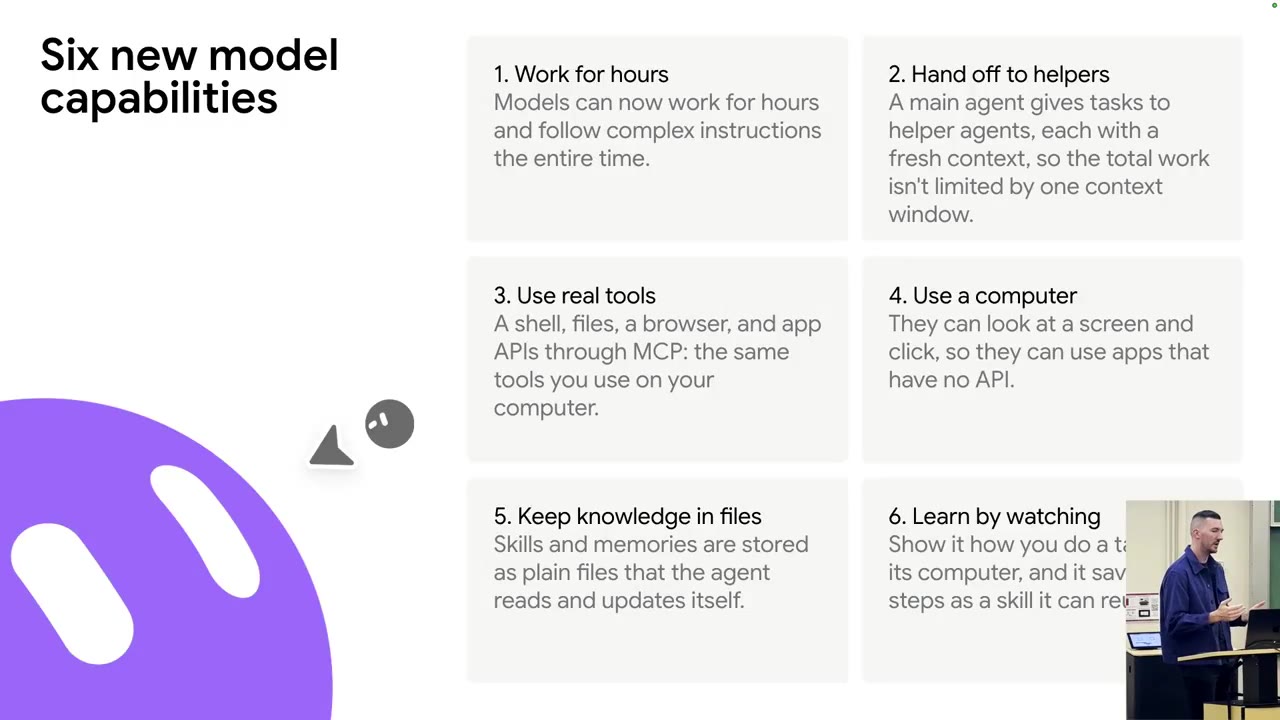
六项新能力(Six new model capabilities)6:20
- 连续工作几个小时。
- 交给帮手:派出子 agent(sub-agent)去干活,避免把主 agent 的上下文窗口塞满。
- 使用真实工具:API、浏览器、shell。他说工具调用里的幻觉问题“基本算是解决了”(7:26)。
- 使用电脑:在无界面(headless)的 Linux 桌面上操作那些没有 API 的老软件。
- 把知识存在文件里。
- 看着学:把演示视频变成可重复执行的 routine。
六项能力 agent 知道的东西,都在文件里(What the agent knows lives in files)8:29
目录结构类似:
memory/profile.md、skills/linkedin-sourcing.md、routines/morning-brief。用户偏好(比如“回复用小写”)就写在 Markdown 里,随时可读可改。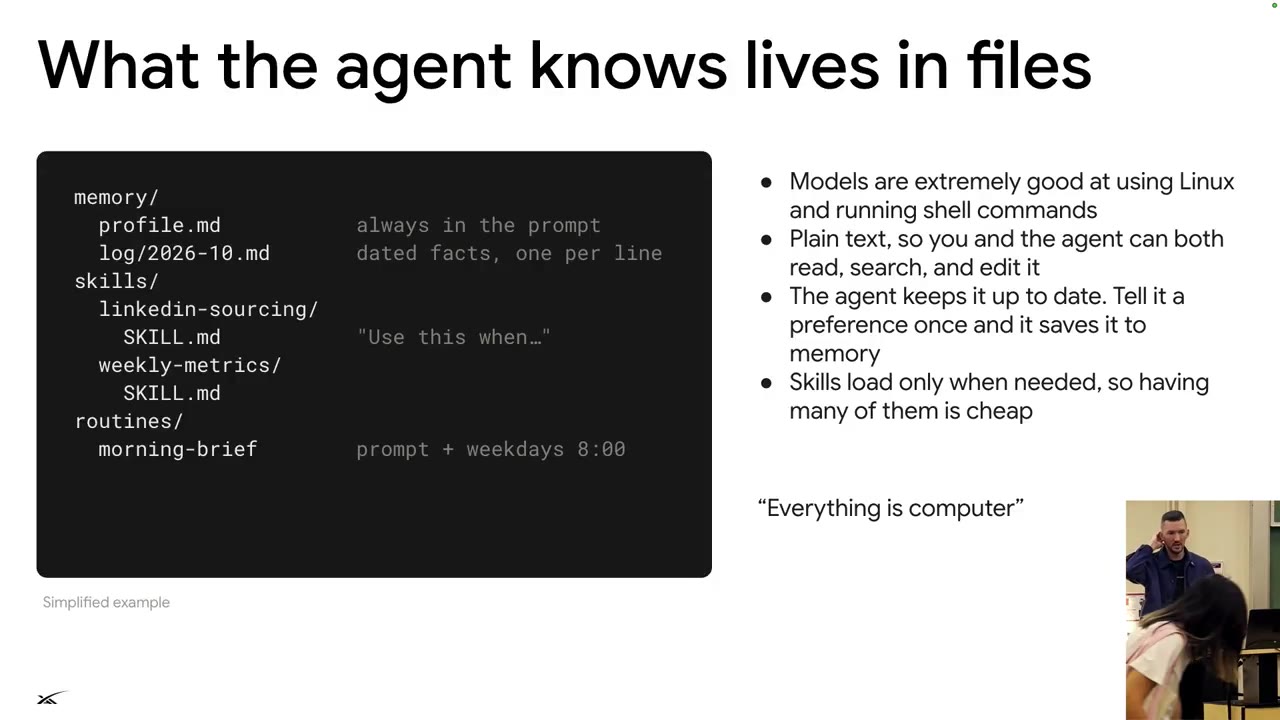
文件即记忆
三、always-on agent 的内部结构(Inside an always-on agent)10:06
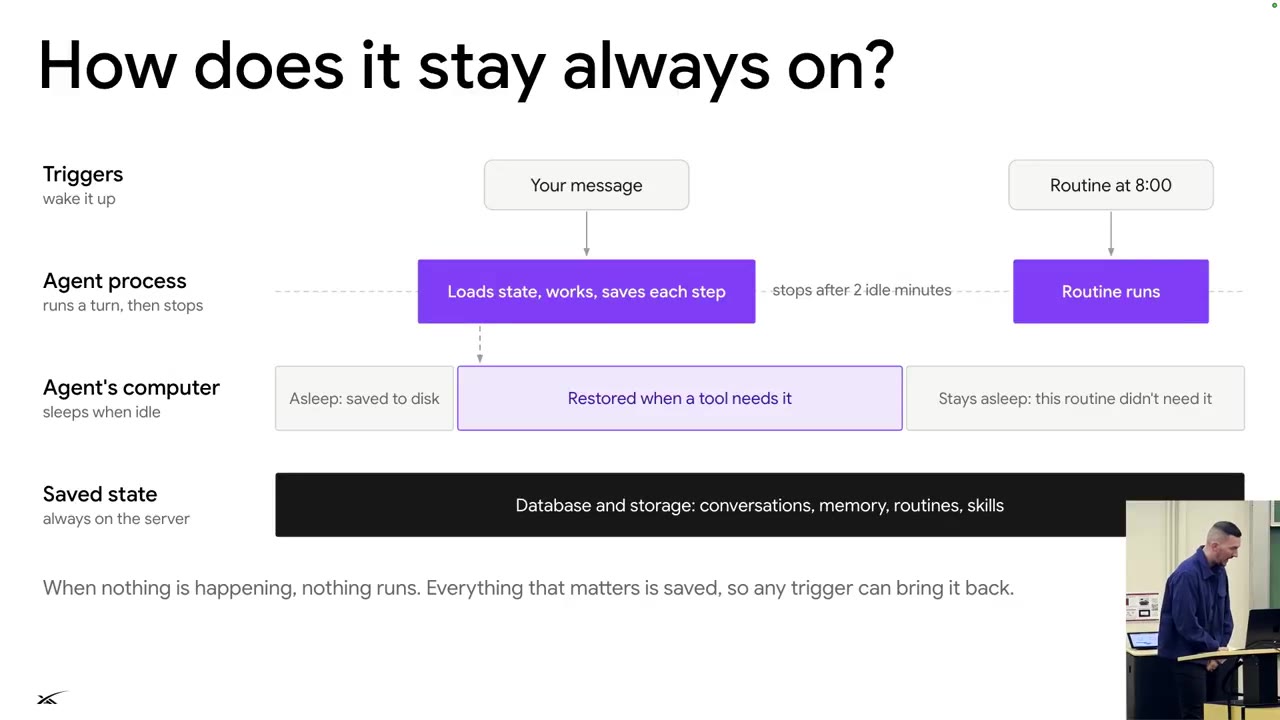
它怎么做到一直在线?(How does it stay always on?)10:10
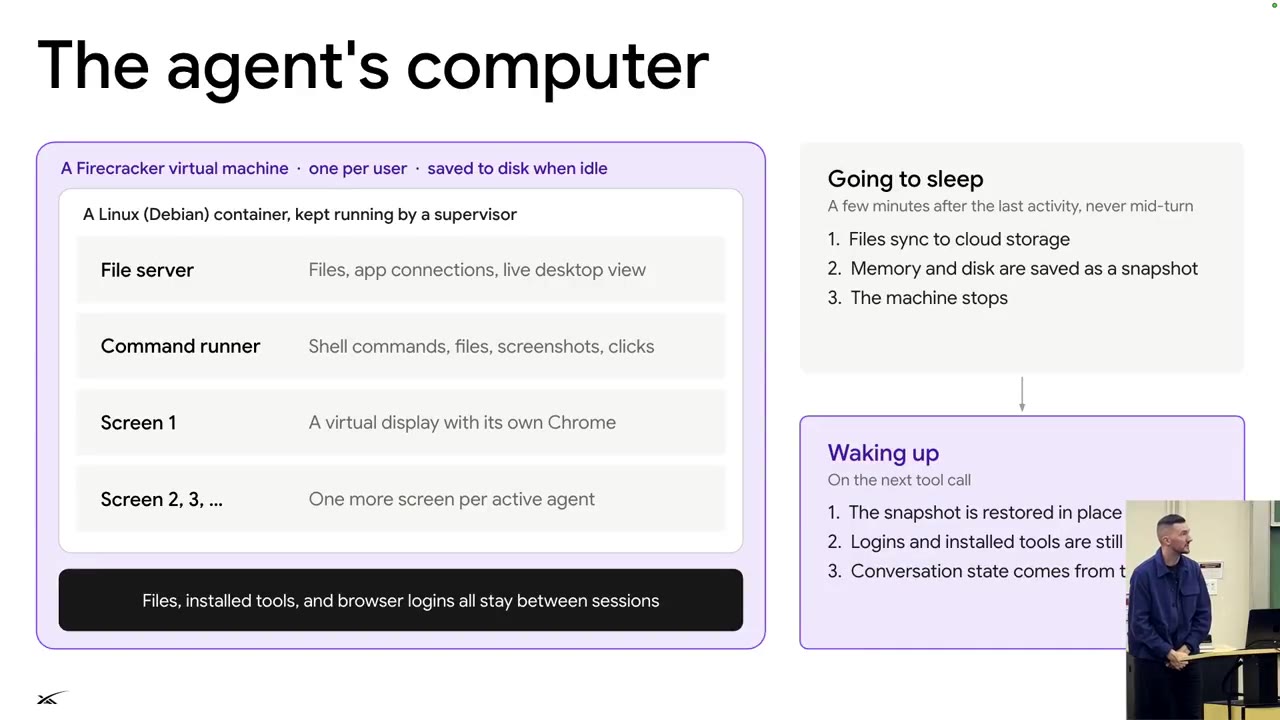
答案有点反直觉:闲下来时进程其实会停掉,虚拟机被存到磁盘上,以此省钱。“一直在线”是指随叫随到,不是一直在烧算力。
如何保持在线 什么会唤醒 agent(What wakes the agent)11:13
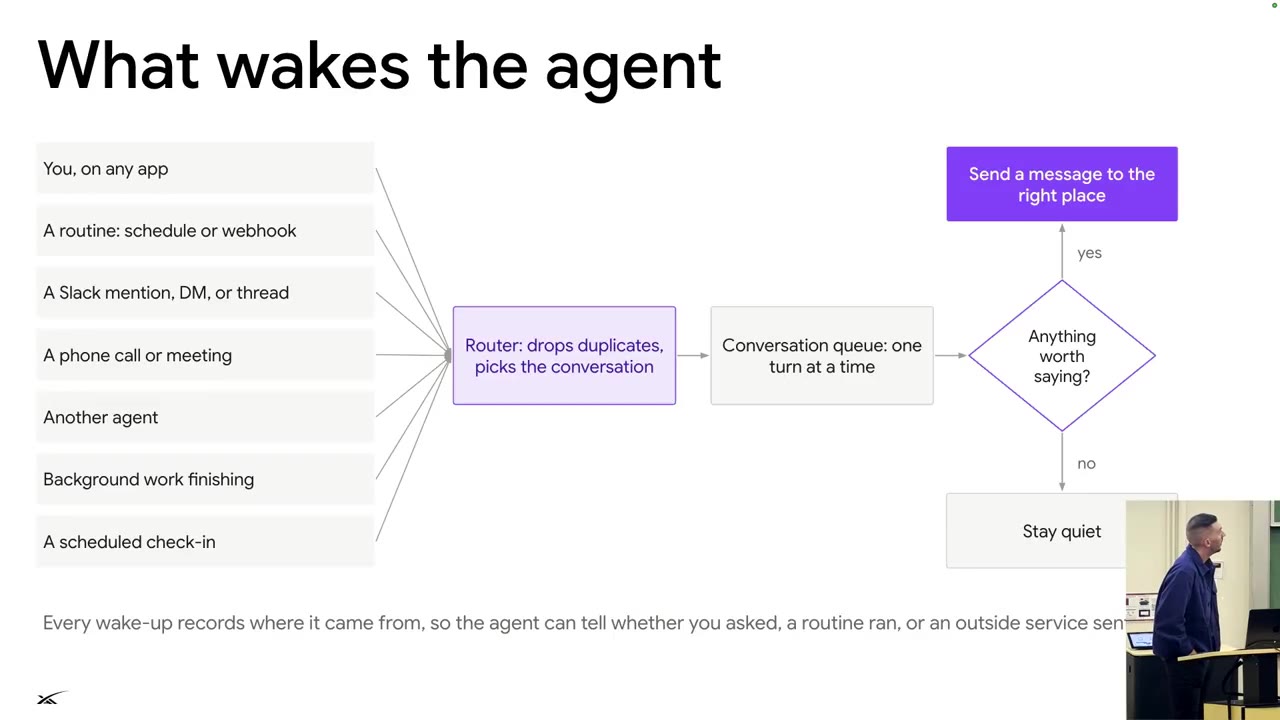
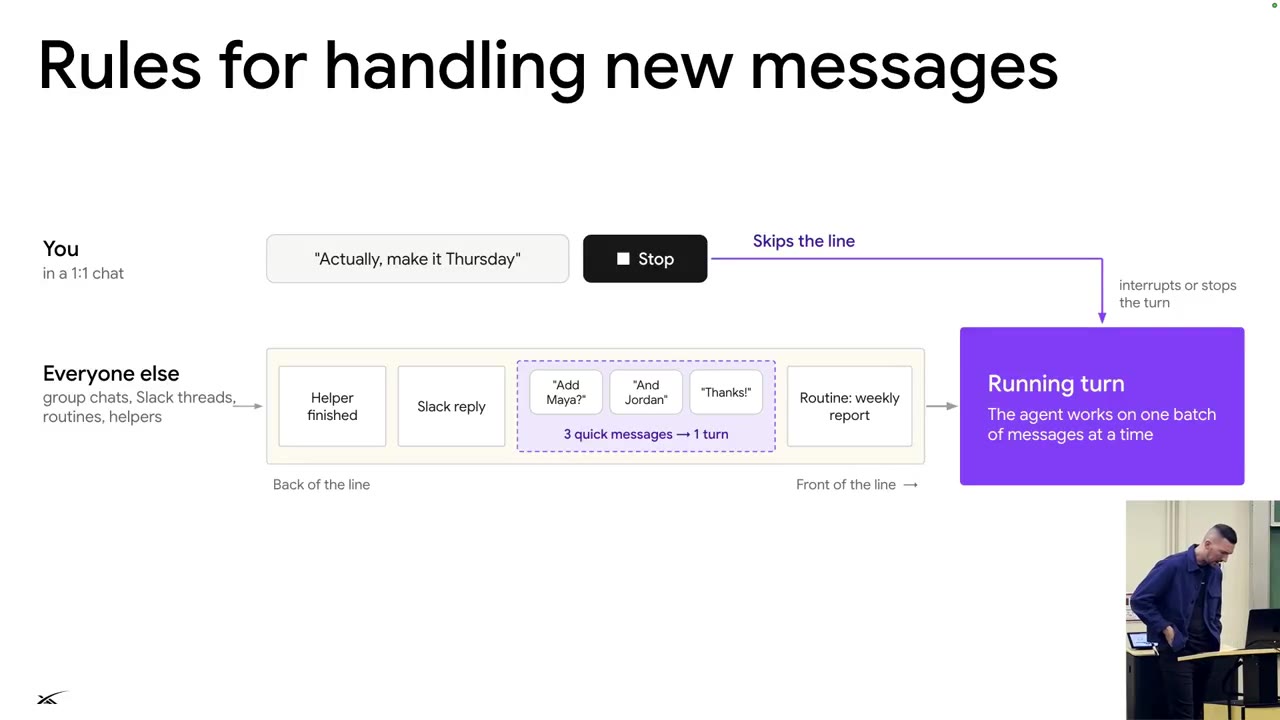
私信、定时任务(cron / routine)、Slack 里被 @、后台任务跑完。所有事件先经过一个路由器:去掉重复事件,并且一次只处理一轮(turn)。
唤醒来源 agent 的电脑(The agent's computer)12:19
每个 agent 跑在一台 Firecracker 虚拟机里,里面有文件服务、命令执行器,以及运行 Chrome 的虚拟显示器。
注:Firecracker 是 AWS 开源的轻量级虚拟机技术,启动快、隔离性好,常用于 serverless。
agent 的电脑 所有东西都存在服务器上(Save everything on the server)15:05
记忆和磁盘都会做快照,这样虚拟机可以随时重建,比如打完 Linux 补丁之后。
保存一切 持久化工作流 vs. 任务队列(Durable workflows vs. job queues)16:17
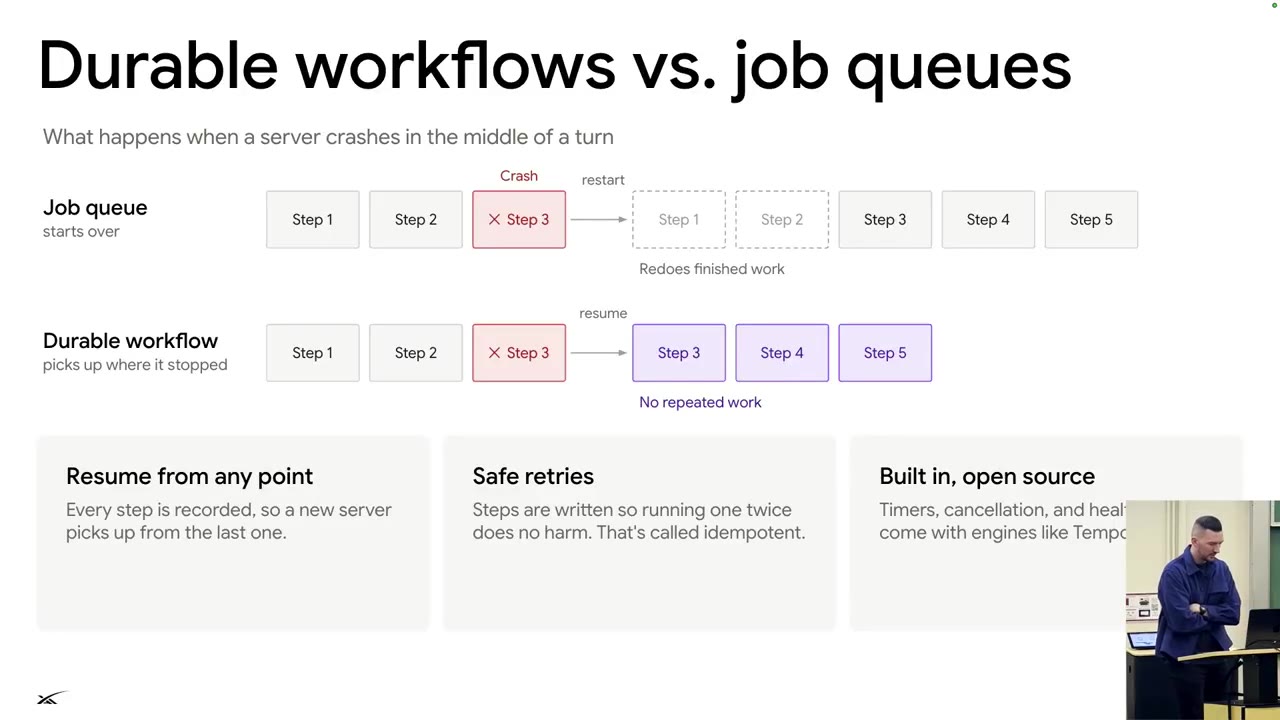
他们用 Temporal(17:09)。如果流程在第 3 步崩了,恢复后从第 3 步继续,而不是从头再来——避免像“给供应商付两次款”这种重复操作。
注:Temporal 是一个持久化工作流引擎,会记录每一步的执行结果,进程挂掉后能从断点继续。
Durable workflows 新消息的处理规则(Rules for handling new messages)17:19
用户一对一发来的消息可以插队,并打断当前任务;群聊消息和子 agent 发来的消息则排队等待。
消息规则
四、Harness:模型外面的那层“外壳”18:07
只用一个工具跟你说话(One tool for talking to you)18:20
agent 只有一个“发消息给用户”的工具。内部的思考过程不会直接展示出来,用户只看到它决定要说的话。
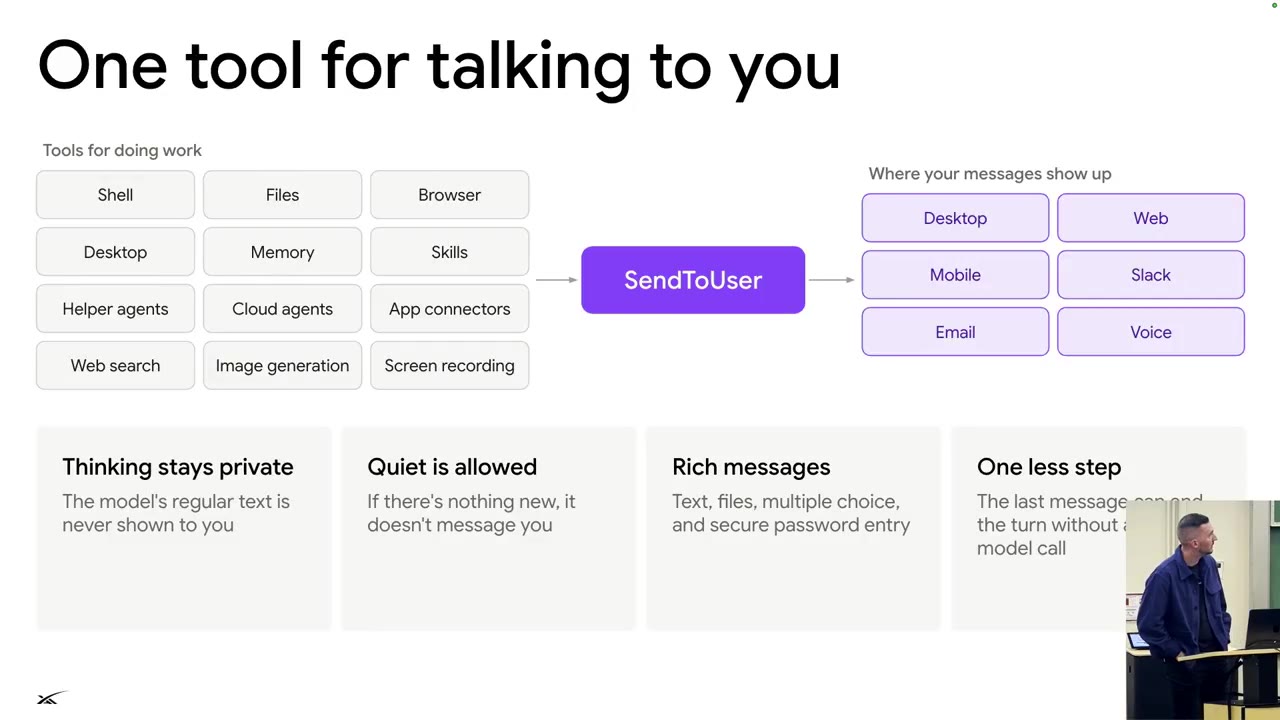
单一发送工具 工具要配上合适的界面(Pairing tools with the right UI)19:14
有些操作要配交互组件,比如 1Password 登录卡片、Stripe 付款审批卡片,而不是纯文字。
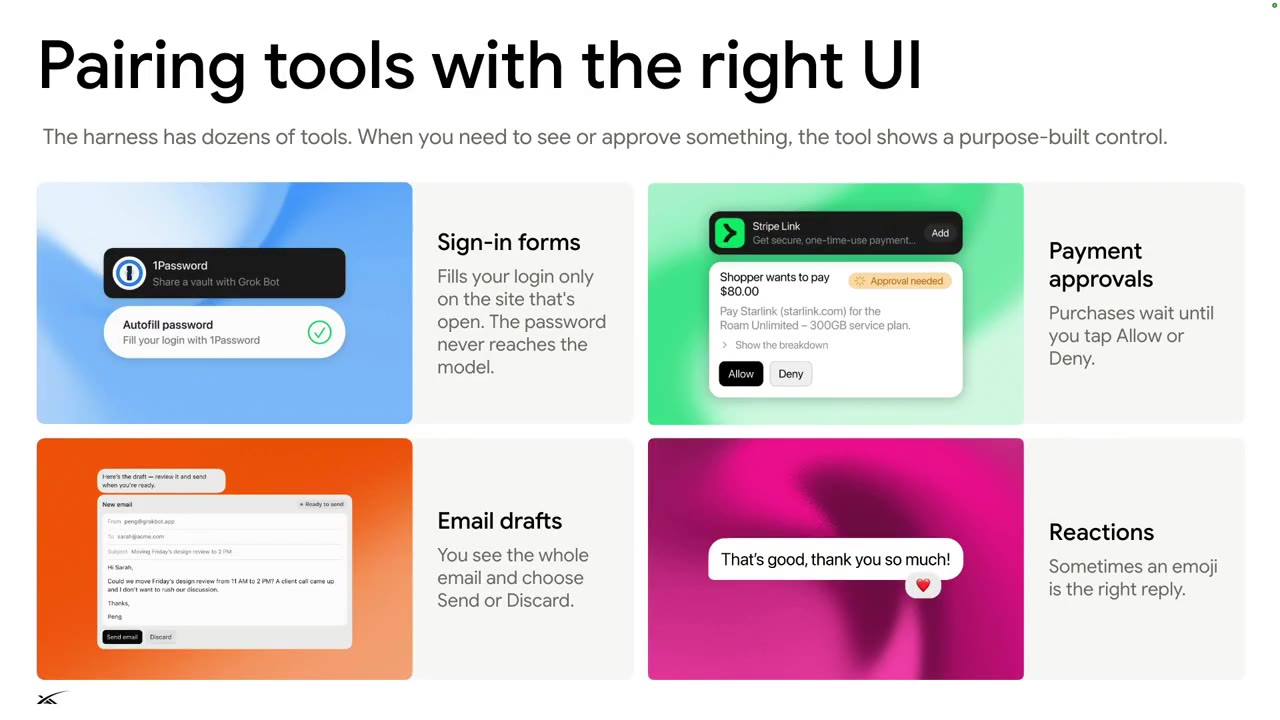
工具配 UI 工具细节按需加载(Load tool details only when needed)19:59
即“工具搜索”:一开始只给模型工具的名字,具体参数结构(schema)等需要时再加载(20:53),节省上下文。
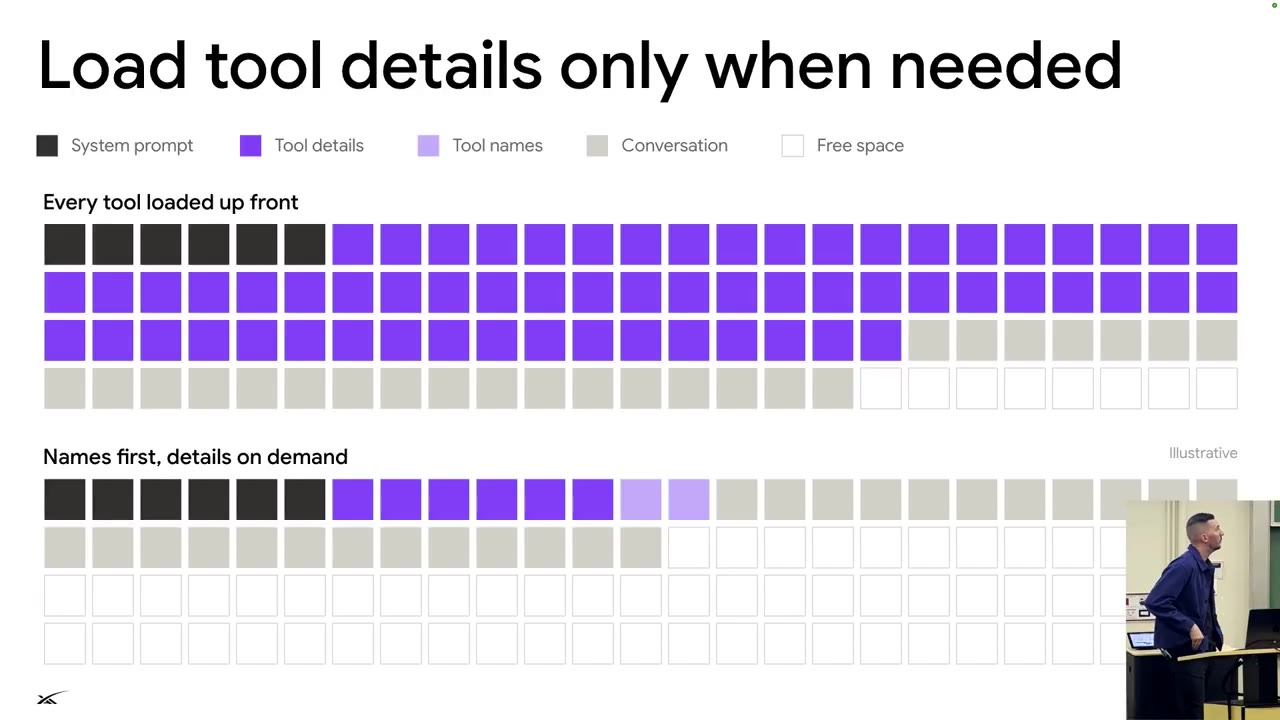
按需加载工具 先试最便宜的办法(Try the cheapest option first)21:31
一个由低到高的阶梯:
- 已经知道的
- API / 连接器
- 网页搜索
- 已登录的浏览器
- 完整桌面图形界面
- 问用户
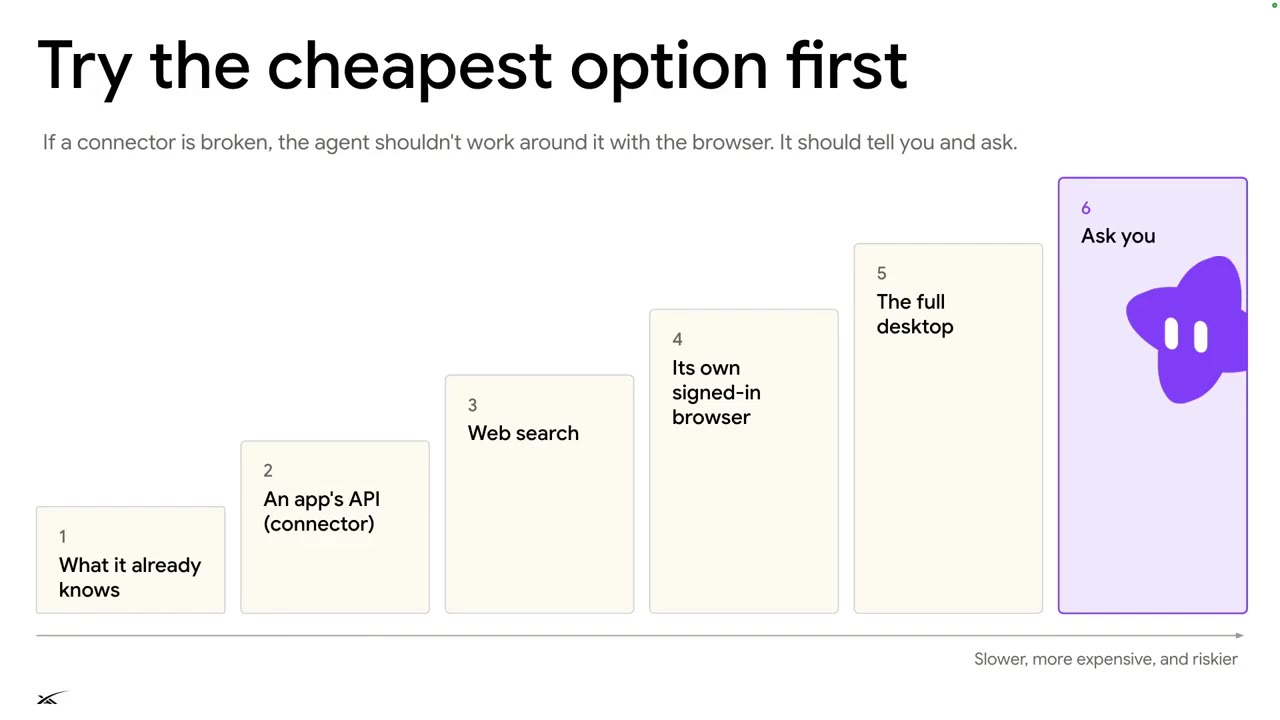
成本阶梯 一个主 agent,多个帮手(One main agent, many helpers)23:30
主 agent 把任务分派给通用帮手、电脑操作帮手、视频帮手,以及云端编程 agent,让自己的上下文保持干净。
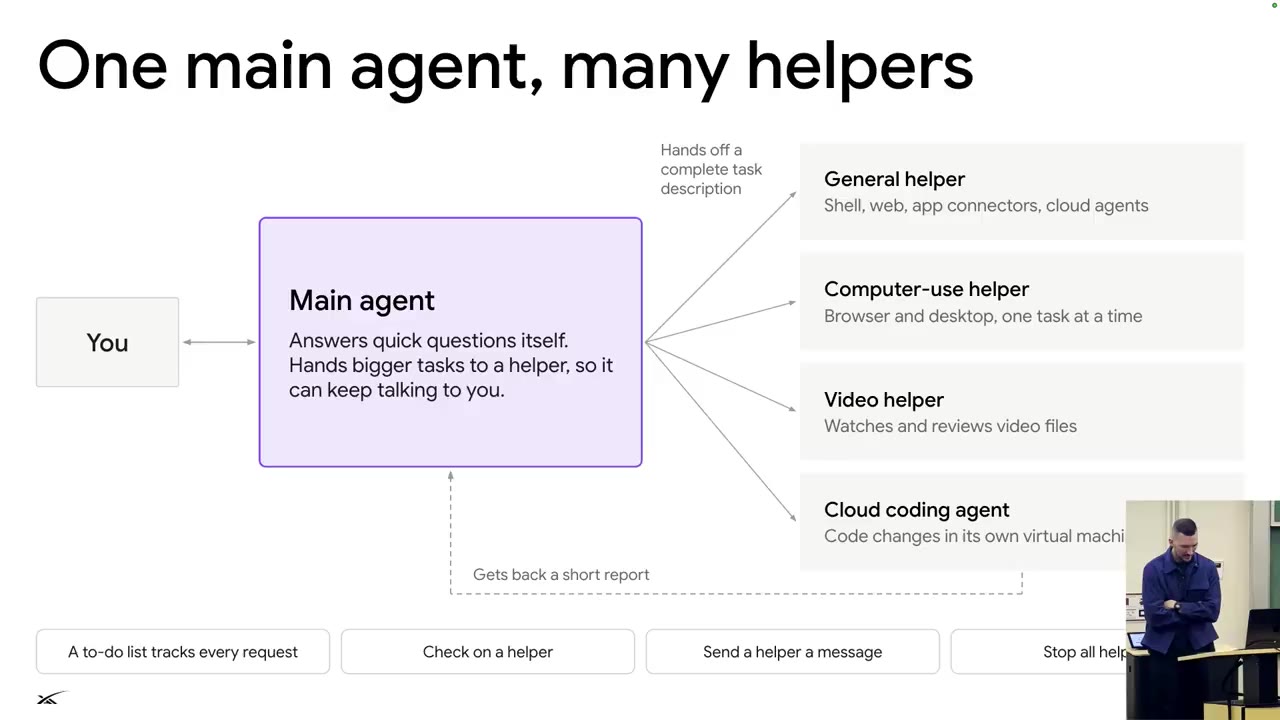
主从 agent
五、上下文工程(Context engineering)27:26
保持提示词开头不变(Keep the start of the prompt the same)27:46
为了用上 prompt caching,把不变的内容——系统提示词、工具、记忆——放在最前面。
注:prompt caching 指模型服务商把提示词相同的前缀缓存起来,下次请求开头一致时就能复用,更快也更便宜;开头一变,缓存就失效。
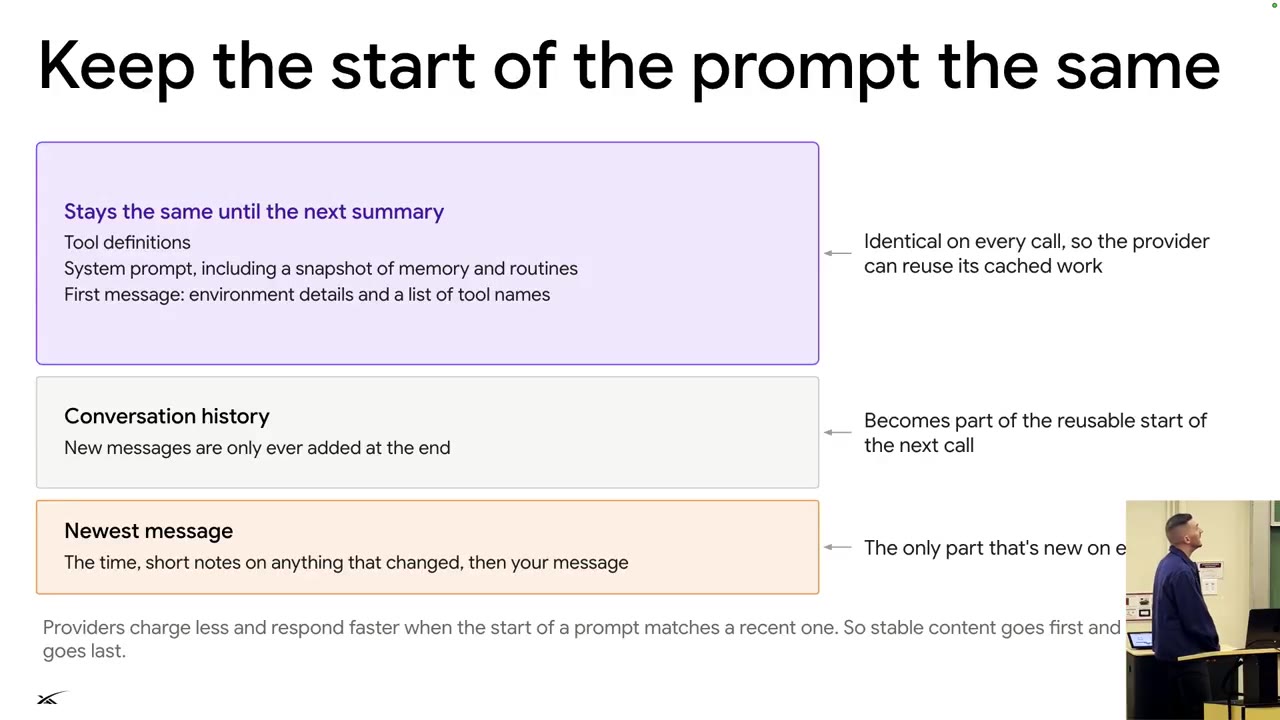
稳定前缀 把缓存未命中当成 bug(Treat a cache miss like a bug)29:50
用户打开聊天窗口、或开始打字时,就提前“预热”缓存。
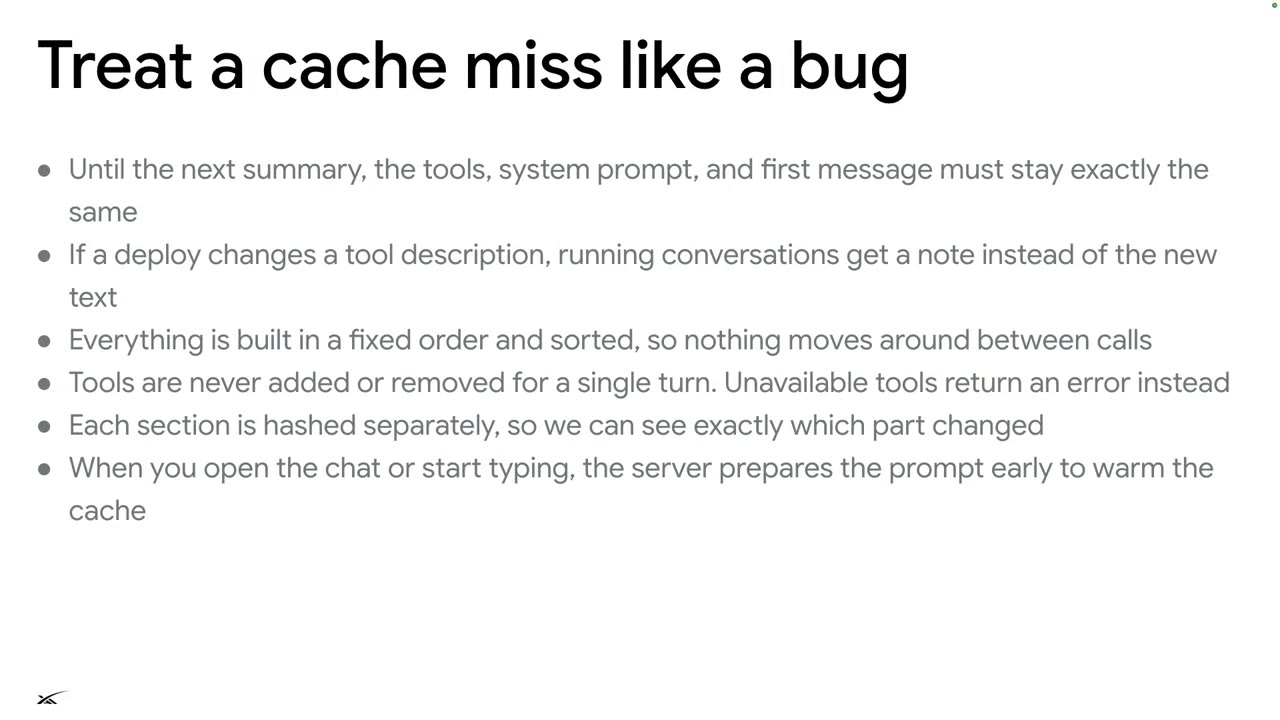
缓存未命中 趁你不在时做总结(Summarize while you're away)31:31
压缩上下文(compaction)是有损的。最好在用户空闲、而缓存还热着(大约 10 分钟内)的时候做。
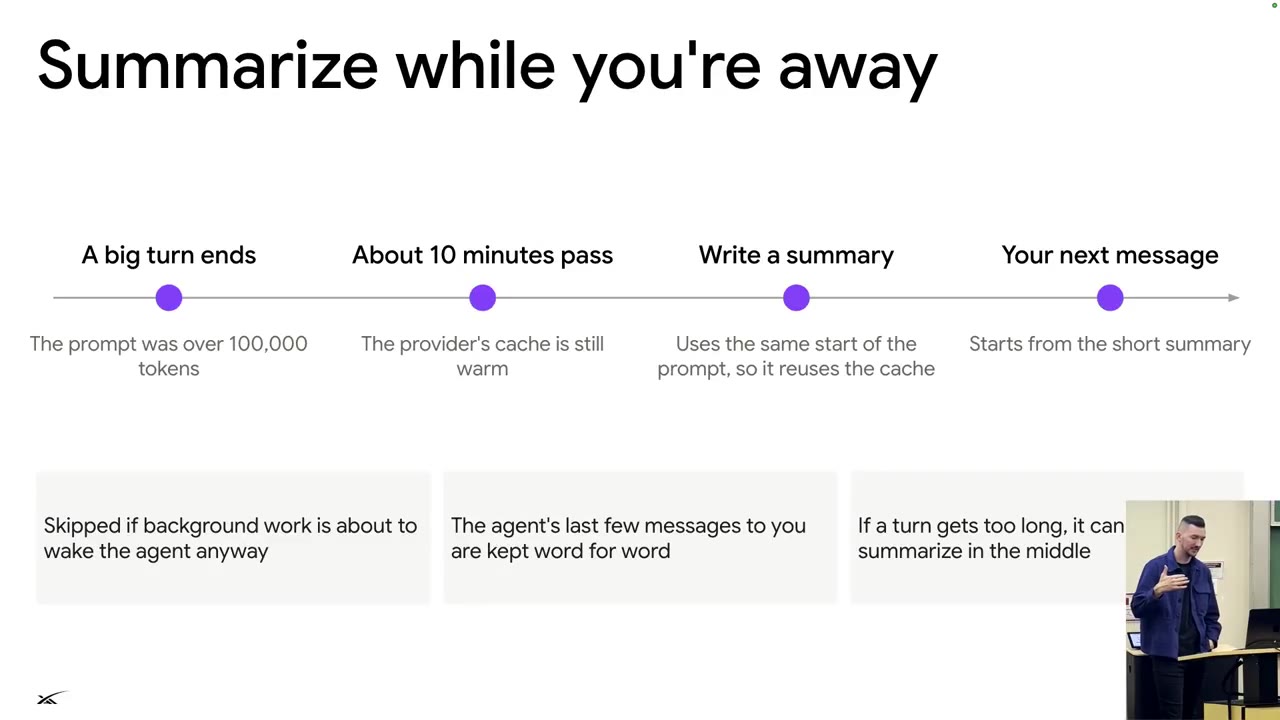
离开时压缩
六、未来方向(Where this is going)34:26
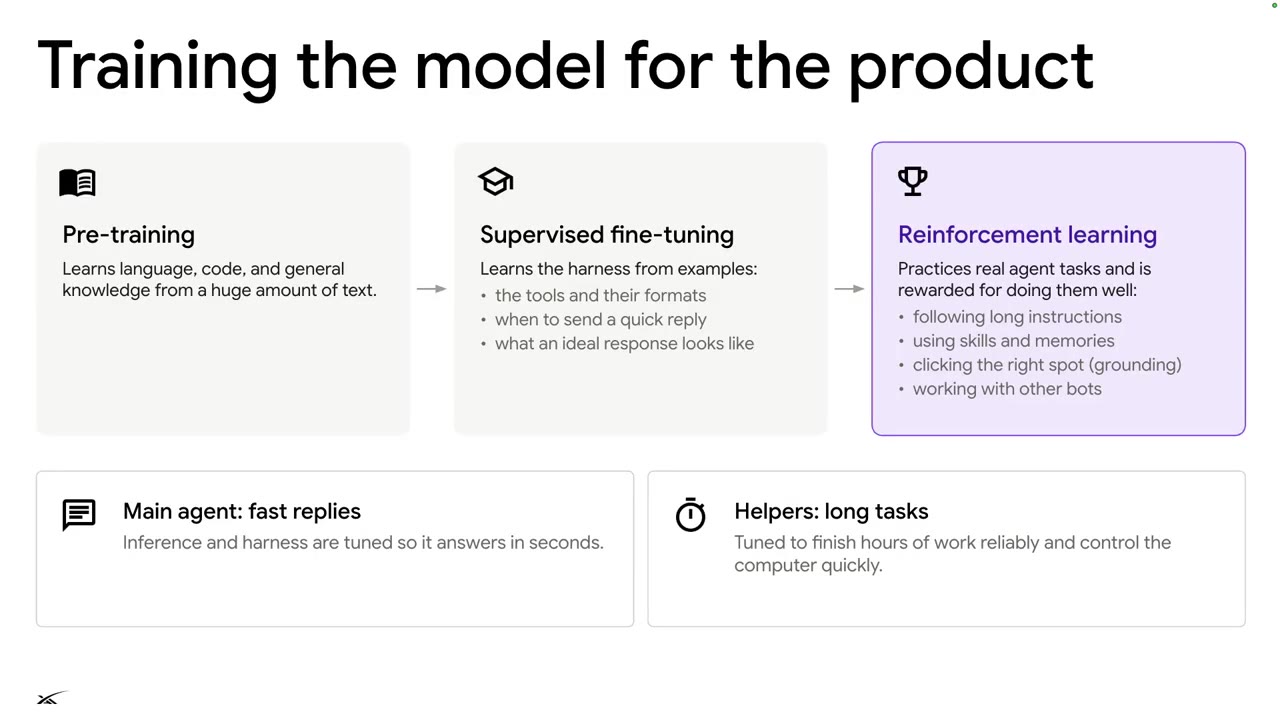
为产品训练模型(Training the model for the product)34:29
- 预训练:学通用知识。
- SFT(监督微调):学会 harness 要求的格式,比如 JSON。
- RL(强化学习):学会多步骤的 agent 任务。
- 形成飞轮:产品数据反哺模型。
训练模型 把产品删掉(Delete the product)37:44
“假设模型会变得好得多。围绕它们尽量少建东西,并把它们不再需要的部分删掉。”
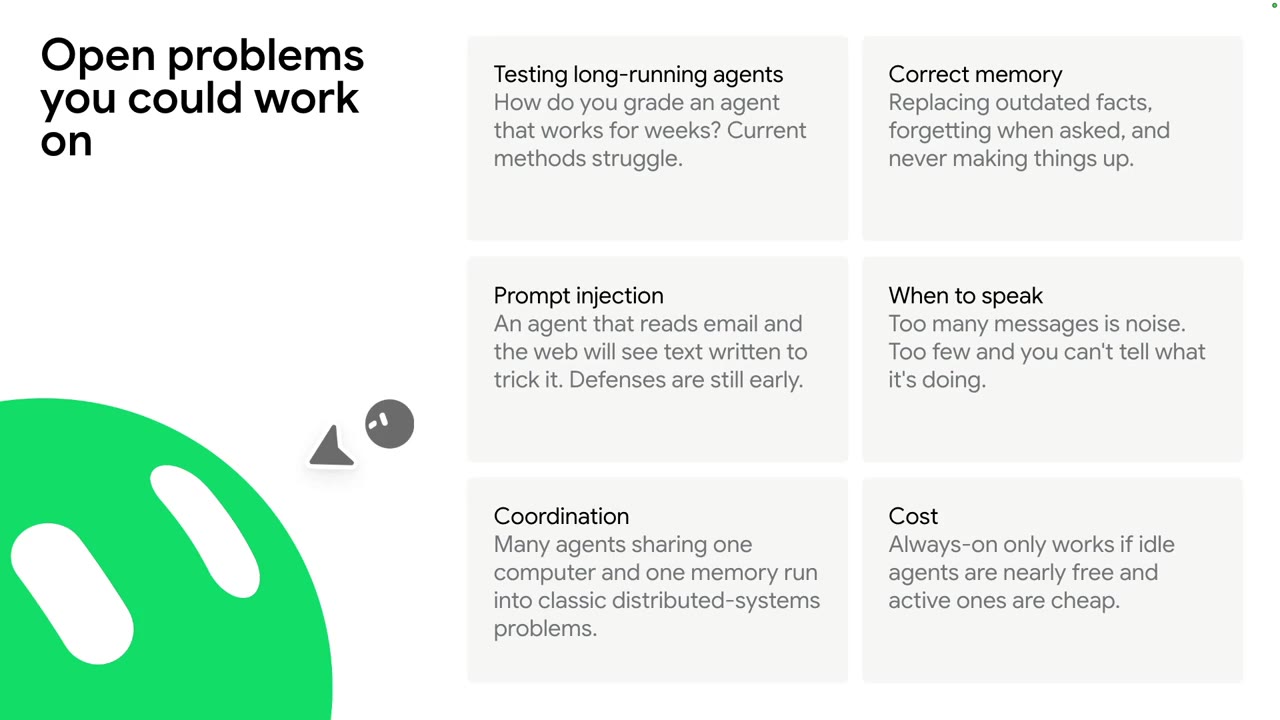
Delete the product 你可以去研究的开放问题(Open problems you could work on)40:21
- 如何测试长时间运行的 agent。
- 提示词注入(prompt injection)——还处在早期。
- 算力成本。
- 多 agent 协同——本质上是分布式系统问题。
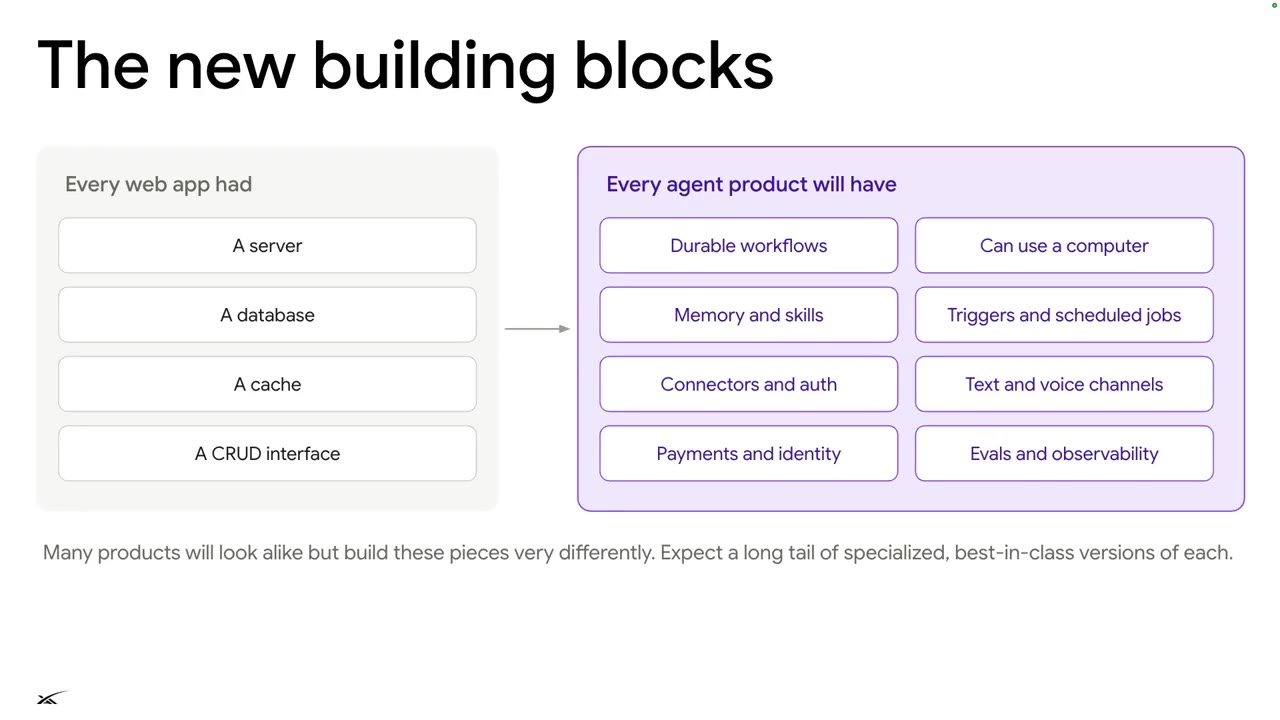
开放问题 新的基础组件(The new building blocks)42:04
传统 Web 技术栈:服务器、数据库、缓存、CRUD。agent 技术栈:持久化工作流、记忆、电脑操作、可观测性。
新的构建模块 结束(Thank you)45:11
以感谢页收尾,没有问答环节。
Thank you